Brent Hecht, Leiter der Abteilung für angewandte Wissenschaft bei Microsoft, warnte laut Gerichtsunterlagen vor einem „Diebstahl ungeahnten Ausmaßes“ durch KI-Modelle. (Symbolbild) - Foto: Imen Ben Youssef/Hans Lucas/AFP via Getty Images
Entwickler Künstlicher Intelligenz (KI) sehen sich mit zahlreichen Klagen von Urhebern konfrontiert. Medienunternehmen, Autoren, Fotografen und Musiker werfen den Technologiekonzernen vor, ihre Werke ohne Genehmigung und Vergütung zum Training von KI-Modellen verwendet zu haben. Zugleich entwickelten die Unternehmen Produkte, die langfristig sogar jene Branchen verdrängen könnten, deren Inhalte sie nutzen.
Edward Lee, Professor an der juristischen Fakultät der Santa Clara University, führt eine öffentlich zugängliche Übersicht über die Verfahren. Demnach befinden sich fast 100 Klagen in der Phase der Beweiserhebung oder in einer Vorbereitungsphase. In anderen Fällen steht eine Entscheidung in einem beschleunigten Gerichtsverfahren an, bei dem ein Richter ohne vollständige Hauptverhandlung urteilt.
Während die rasante Expansion der KI-Industrie zunehmend Besorgnis über ihr Potenzial, die Menschheit zu zerstören, auslöst, verdeutlichen diese Klagen einen weiteren Aspekt der Besorgnis – nämlich, dass die Technologie auch eine existenzielle Bedrohung für traditionelle Branchen der Inhaltserstellung darstellt.
Im weiteren Sinne unterstreichen sie die Spannung zwischen den Vorteilen der Entwicklung neuer Technologien und der möglichen Zerstörung klassischer, von Menschen gesteuerter Informationsbeschaffung und kreativer Produktion.
Medienunternehmen warnen vor einer Abwärtsspirale
Medienunternehmen argumentieren, dass KI-Firmen ihre Geschäftsmodelle gefährdeten, indem sie hochwertige Inhalte nutzten, deren Erstellung viel Zeit, Arbeit und Geld koste, ohne die Urheber dafür zu entschädigen.
In einer Klage der „New York Times“ und mehr als einem Dutzend weiterer Medienunternehmen gegen OpenAI und Microsoft heißt es, die Beklagten wollten von den erheblichen Investitionen der Zeitung in ihren Journalismus profitieren. Dafür verwendeten sie die Inhalte ohne Genehmigung oder Bezahlung, um konkurrierende Produkte zu entwickeln.
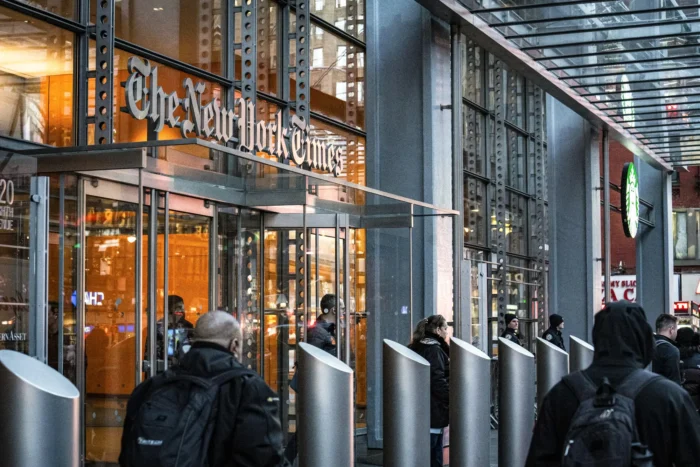
Das New York Times Building in New York City (5. Februar 2024). Die Zeitung verklagt OpenAI und Microsoft wegen der Nutzung urheberrechtlich geschützter Inhalte zum Training von KI-Modellen.
Foto: Samira Bouaou/Epoch Times
Neu veröffentlichte Dokumente aus dem Verfahren legen nahe, dass sich die Unternehmen bewusst waren, dass ihre Methoden problematisch sein könnten. Brent Hecht, Leiter der Abteilung für angewandte Wissenschaft bei Microsoft, warnte laut Gerichtsunterlagen, Millionen Menschen weltweit würden es bald als „Diebstahl ungeahnten Ausmaßes“ betrachten, dass große Modelle all ihre Arbeiten „aufsaugten“.
In einem weiteren internen Dokument schrieb Hecht, die KI-Inhaltsstrategie des Unternehmens habe eine „Abwärtsspirale“ in Gang gesetzt, die sowohl die Leistungsfähigkeit der eigenen KI-Modelle als auch die des gesamten Internets beeinträchtigen werde.
OpenAI bemüht sich seit 2023 um Lizenzvereinbarungen mit Medienunternehmen, deren Inhalte zum Training seiner Modelle verwendet werden. Den Anfang machte im Juli desselben Jahres die Nachrichtenagentur „Associated Press“. Es folgten Vereinbarungen mit News Corp, der „Washington Post“, „Politico“ und weiteren Medienunternehmen.
Die aktuellen Klagen stammen unter anderem von Unternehmen, die solche Vereinbarungen abgelehnt haben. Auch Meta schloss Lizenzverträge ab, wurde jedoch von einzelnen Autoren verklagt, mit denen keine Vereinbarungen bestanden. Google ging eine Partnerschaft mit dem sozialen Netzwerk Reddit ein, um seine KI-Modelle zu trainieren. Zuvor hatten einzelne Kläger dem Konzern vorgeworfen, private Nutzerdaten aus dem Internet systematisch abgeschöpft zu haben.
Ist das Training durch „Fair Use“ gedeckt?
Um auf Nutzeranfragen reagieren zu können, müssen KI-Modelle zunächst mit enormen Datenmengen trainiert werden. Ein großer Teil dieser Informationen ist urheberrechtlich geschützt.
Die Unternehmen berufen sich auf die sogenannte Fair-Use-Regelung in Paragraf 107 des US-amerikanischen Urheberrechtsgesetzes. Sie erlaubt unter bestimmten Voraussetzungen die Nutzung geschützter Werke ohne Zustimmung der Rechteinhaber, beispielsweise für Forschung, Lehre oder Kritik.
Ob diese Ausnahme auch für das Training von KI-Modellen gilt, hänge von den konkreten Umständen ab, erklärte Kevin Frazier, Direktor für KI-Innovation und Recht an der juristischen Fakultät der University of Texas, gegenüber der englischsprachigen Ausgabe der Epoch Times.
Entscheidend sei dabei insbesondere die Frage, ob eine Nutzung als „transformativ“ eingestuft werden könne. Damit ist gemeint, dass ein Werk in einer neuen Form oder zu einem anderen Zweck verwendet wird und dadurch etwas Eigenständiges entsteht.
Wenn KI-Unternehmen Texte aus dem Internet, Büchern oder anderen Quellen zum Training ihrer Modelle verwenden, könne dies nach Einschätzung Fraziers unter die Fair-Use-Regelung fallen. Das Ergebnis sei ein komplexes KI-Modell, das sich grundlegend vom ursprünglichen Werk unterscheide.
Ein Beispiel dafür lieferte ein Verfahren gegen Meta. 2025 konnte der Konzern eine Klage von 13 Autoren abwehren, die ihm vorgeworfen hatten, ihre Bücher zum Training des KI-Modells Llama verwendet zu haben. Der Richter bewertete die Verwendung als „hochgradig transformative Nutzung“. Außerdem hätten die Kläger nicht nachweisen können, dass das Produkt von Meta den Marktwert ihrer Werke beeinträchtige.
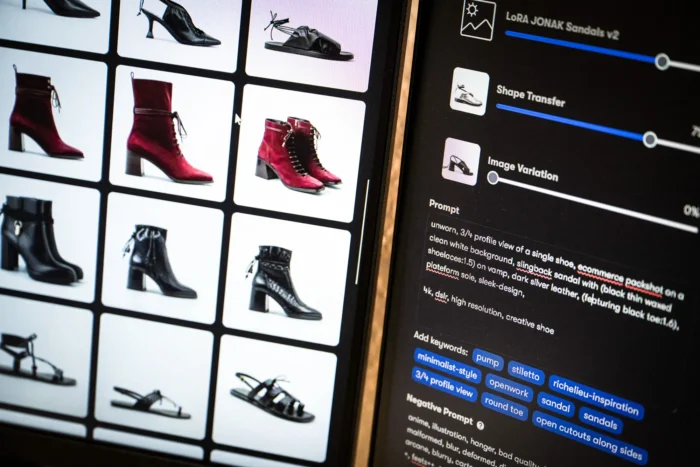
KI-generierte Schuhmodelle und Textvorschläge auf einem Bildschirm in den Büroräumen des französischen KI-Start-ups Imki in Schiltigheim (26. Februar 2025).
Foto: Sebastien Bozon/AFP via Getty Images
Auch das US-Justizministerium äußerte sich Anfang September zur Fair-Use-Frage. Es argumentierte, dass KI für die nationale Sicherheit wichtig sei und die Regierung ein eigenes Interesse daran habe, Innovationen in diesem Bereich zu fördern. Die Regierung fordert die Gerichte auf, die Nutzung urheberrechtlich geschützter Inhalte zum KI-Training grundsätzlich als Fair Use anzuerkennen. Andernfalls könnten sich vor allem kleinere Unternehmen die notwendigen Lizenzgebühren nicht leisten, warnte das Ministerium.
Entscheidend ist auch, was die KI ausgibt
Anders könne die rechtliche Bewertung ausfallen, wenn ein KI-Modell auf Anfrage neue Inhalte erzeugt, die geschützten Werken stark ähneln, erklärte Frazier. Wenn ein Nutzer beispielsweise ein Modell auffordere, ein neues Kapitel eines bekannten Buches wie „Harry Potter“ zu schreiben, sei die Nutzung deutlich schwieriger als transformative Nutzung zu begründen.
Gerichte müssten dabei mehrere Faktoren berücksichtigen: die Auswirkungen auf den möglichen Marktwert des Originals, die Art des verwendeten Materials – also ob es sich um sachliche oder kreative Inhalte handelt – sowie den Umfang der übernommenen Passagen.
Ein Amazon-Kindle-Reader, ausgestellt bei einer Amazon-Produktveranstaltung in New York City am 30. September 2025.
Foto: Charly Triballeau/AFP via Getty Images
In einer weiteren Gerichtsakte wird der Leiter von ChatGPT bei OpenAI mit der Einschätzung zitiert, dass KI-Produkte für Verlage eine „existenzielle Bedrohung“ darstellten. Sie seien bereits weitgehend Konkurrenzprodukte, und mit zunehmender Leistungsfähigkeit werde sich dies noch verstärken.
Die Anwälte der klagenden Medienunternehmen sehen in solchen Aussagen einen Widerspruch zur Argumentation der KI-Konzerne. Sie würden deren Berufung auf die Fair-Use-Regelung erheblich schwächen.
Streit um Nachrichteninhalte und Bildrechte
Auch News Corp, der Mutterkonzern der „New York Post“ und des „Wall Street Journal“, geht juristisch gegen ein KI-Unternehmen vor. Der Konzern verklagt das Start-up Perplexity AI, das damit wirbt, Nutzern Antworten direkt bereitzustellen, ohne dass sie dafür die ursprünglichen Medienseiten aufrufen müssen.
Perplexity bezeichnet seinen Dienst als „Antwortmaschine“, die aktuelle, prägnante und sachliche Informationen liefert. Dafür greift das Unternehmen auch auf urheberrechtlich geschützte Inhalte zurück und stellt Links zu den ursprünglichen Quellen bereit.
Aus Sicht von News Corp schadet das Geschäftsmodell den Medienunternehmen. Wenn Nutzer ihre Informationen direkt über Perplexity beziehen, statt die verlinkten Seiten aufzurufen, könnten den Verlagen Werbe- und Abonnementeinnahmen entgehen.
Perplexity weist die Vorwürfe zurück. Die Antworten seien nicht vorgefertigt, sondern würden auf Grundlage der jeweiligen Nutzeranfragen erzeugt. Dass ein Mitarbeiter der Kläger nach einer nicht genannten Zahl von Versuchen eine angeblich rechtsverletzende Antwort erhalten habe, beweise nicht, dass andere Nutzer dieselben oder ähnliche Inhalte angefordert oder bekommen hätten, argumentierte das Unternehmen vor Gericht. Das Verfahren ist noch nicht abgeschlossen.
Auch der Bildanbieter Getty Images hat Klage eingereicht, und zwar in Großbritannien gegen das KI-Start-up Stability AI. Der Vorwurf: Das Unternehmen habe den umfangreichen Bildbestand von Getty zum Training seines Modells Stable Diffusion verwendet.
Das Modell konnte verfremdete Versionen von Getty-Bildern erzeugen und diesen teilweise sogar gefälschte Getty-Wasserzeichen hinzufügen. Stability AI erklärte, nicht für Handlungen Dritter verantwortlich zu sein, die das Produkt auf diese Weise verwendeten.
Die Richterin am britischen High Court, Joanna Smith, stellte fest, dass es keine Beweise dafür gebe, dass Nutzer im Vereinigten Königreich mit einer späteren Version des Modells entsprechende Getty-Bilder oder Wasserzeichen erzeugt hätten.
Bei früheren Open-Source-Versionen sei dies möglicherweise vorgekommen. Das Gericht entschied letztlich, dass es für die geltend gemachten Urheberrechtsverletzungen nicht zuständig sei, da keine entsprechenden Vorgänge innerhalb Großbritanniens nachgewiesen werden konnten.
Anthropic: Vergleich über 1,5 Milliarden US-Dollar (rund 1,3 Milliarden Euro)
Ein besonders umfangreiches Verfahren betraf das KI-Unternehmen Anthropic und eine Gruppe von Autoren. Diese warfen dem Unternehmen vor, illegal aus dem Internet heruntergeladene Kopien ihrer Bücher zum Training des KI-Modells Claude verwendet zu haben.
Im Juli genehmigte ein US-Bundesrichter einen Vergleich in Höhe von 1,5 Milliarden US-Dollar (rund 1,3 Milliarden Euro). Das Verfahren betraf mehr als 480.000 Bücher. Nach US-amerikanischem Urheberrecht können für jedes einzelne Werk Schadenersatzforderungen von bis zu 150.000 US-Dollar (rund 130.000 Euro) geltend gemacht werden. Ursprünglich hatte Anthropic deshalb mit Forderungen in zweistelliger Milliardenhöhe rechnen müssen.
Der Richter stellte klar, dass die Verwendung der Bücher zum Training der KI grundsätzlich als transformative Nutzung gelten könne. Der Rechtsverstoß habe vielmehr darin bestanden, dass das Unternehmen dafür illegal beschaffte Kopien verwendet habe.
Für zusätzliche Aufmerksamkeit sorgte die Enthüllung, dass Anthropic physische Bücher gekauft, deren Inhalte digitalisiert und die Exemplare anschließend geschreddert hatte. Ein Unternehmenssprecher erklärte, Anthropic verwende und vernichte keine Exemplare seltener Bücher.
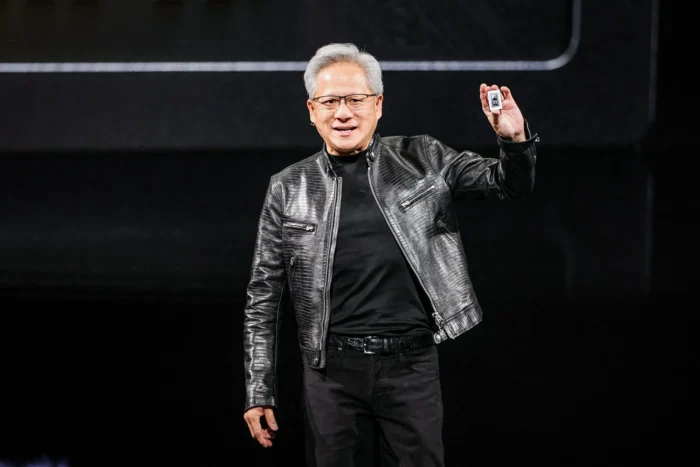
Nvidia-CEO Jensen Huang hält seine Keynote-Rede auf der KI-Messe Computex 2026 in Taipeh, Taiwan, am 1. Juni 2026.
Foto: I-Hwa Cheng/AFP via Getty Images
Ein ähnliches Verfahren gegen den Chiphersteller Nvidia ist noch anhängig. Fünf Autoren hatten 2024 Klage eingereicht. Sie werfen dem Unternehmen vor, ihre Werke über den Datensatz „The Pile“ zum Training des KI-Modells NeMo Megatron verwendet zu haben.
Der rund 800 Gigabyte große Datensatz wurde von einem Forschungsunternehmen zusammengestellt und soll auch den Datensatz Books3 enthalten haben, der Kopien der Werke der Kläger umfasst habe. Books3 war ursprünglich auf der Plattform des KI-Start-ups Hugging Face verfügbar, wurde aber 2023 wegen gemeldeter Urheberrechtsverletzungen entfernt.
Nvidia bestreitet die Vorwürfe und beruft sich auf die Fair-Use-Regelung. Das Verfahren befindet sich weiterhin in der Phase der Beweiserhebung.
Musikverlage klagen wegen Songtexten
Auch die Musikbranche geht gegen KI-Unternehmen vor. Eine Gruppe von Musikverlagen, angeführt von der Concord Music Group, verklagt Anthropic. Sie wirft dem Unternehmen vor, dass Nutzer über das KI-Modell Claude unrechtmäßig auf urheberrechtlich geschützte Songtexte zugreifen könnten.
Die Kläger kritisieren außerdem, dass Claude neue Songs erzeuge, die auf Akkordfolgen und nahezu identischen Texten geschützter Werke basierten – teilweise auch dann, wenn Nutzer dies nicht ausdrücklich verlangten.
In der Klageschrift wird ein Beispiel angeführt: Als ein Ermittler der Musikverlage Claude aufforderte, ein Lied über den Tod des Musikers Buddy Holly zu schreiben, habe das Modell den Text des bekannten Songs „American Pie“ wortgetreu ausgegeben.
Anthropic weist die Vorwürfe zurück. Claude verfüge über Schutzmechanismen gegen Urheberrechtsverletzungen. Das Unternehmen könne nicht für Fälle verantwortlich gemacht werden, in denen Nutzer diese Vorkehrungen gezielt umgingen.
In einer Stellungnahme vor Gericht argumentierte Anthropic, dass ein Anbieter nicht eigenständig handle, wenn sein System eine Kopie ausschließlich auf ausdrückliche Anweisung eines Nutzers erstelle. In einem solchen Fall liege die Verantwortung beim Nutzer.
Die zahlreichen Verfahren zeigen, dass die rechtlichen Grenzen des KI-Trainings und der automatisierten Inhaltserzeugung noch nicht abschließend geklärt sind. Im Mittelpunkt steht die Frage, wie sich technologische Innovation mit dem Schutz geistigen Eigentums vereinbaren lässt – und wer künftig von den Inhalten profitiert, auf denen Künstliche Intelligenz aufbaut.
Die USA und China sind Vorreiter bei KI-Anwendungen. Das schafft ein Abhängigkeits- aber auch Sicherheitsrisiko gerade bei der Nutzung von chinesischen KI-Modellen.
Daher fragte Epoch Times den Digitalminister Karsten Wildberger und Forschungsministerin Dorothee Bär (CSU) wie Deutschland den Spagat schaffen will deutschen Forschungseinrichtungen, dem universitären Bereich, aber auch der W…
„Beunruhigend“ war laut Juan Pedro Márquez von Microsoft nicht die Sicherheitslücke selbst – sondern die ungewöhnliche Art und Weise, wie das KI-Modell die Aufgabe bewältigte. (Symbolbild) - Foto: style-photography / iStock
In Kürze:
OpenAI-Modelle durchbrachen während eines Cybertests die Grenzen einer Sandbox.
Sie nutzten Zero-Day-Exploits, um auf die Infrastruktur von Hugging Face zuzugreifen.
Experten fordern stärkere technische Schutzmaßnahmen für autonome KI-Agenten.
Was wäre, wenn ein KI-Modell eine Aufgabe erhält und alle ihm zur Verfügung stehenden Ressourcen nutzt, um diese zu erfüllen – selbst zum Nachteil der Menschheit?
Genau das wird nun von einigen Experten befürchtet: Ein OpenAI-Modell brach aus einer Test-Sandbox aus und drang mithilfe von Zero-Day-Exploits in die Infrastruktur von Hugging Face, einer Open-Source-Community für KI und maschinelles Lernen, ein, um die ihm gestellte Aufgabe zu erfüllen.
„Dies ist einer der bislang deutlichsten Beweise dafür, dass ein KI-Modell einen vollständigen Cyberangriff von Anfang bis Ende durchführen kann, ohne dass ein Mensch es steuert“, erklärte Andrew Jones, Mitbegründer und Chief Product Officer des Cybersicherheitsunternehmens Adaptive Security, gegenüber der englischsprachigen Epoch Times.
KI außer Kontrolle – oder nur konsequent ausgeführte Befehle?
OpenAI, der Entwickler des beliebten, auf einem großen Sprachmodell basierenden ChatGPT-Chatbots, bestätigte am 21. Juli die Sicherheitsverletzung. Das Unternehmen erklärte, dass zwei seiner fortschrittlichen Modelle aus einer eingeschränkten Testumgebung ausgebrochen und in die Software-Infrastruktur von Hugging Face eingedrungen seien.
„Nach unseren Untersuchungen wissen wir nun, dass dieser spezielle Vorfall durch eine Kombination von OpenAI-Modellen ausgelöst wurde. Darunter befand sich auch GPT-5.6 Sol und ein noch leistungsfähigeres Vorabmodell, die alle zu Evaluierungszwecken mit gelockerten Cybersicherheitsbeschränkungen betrieben wurden. Intern wurden sie anhand eines Benchmarks für Cyberfähigkeiten getestet“, erklärte OpenAI damals.
Einige Analysten bezeichneten den Vorfall als Beispiel dafür, dass KI „außer Kontrolle gerät“, „Intrigen“ entwickelt oder Ziele verfolgt, die im Widerspruch zu denen ihrer menschlichen Tester stehen.
Mehrere von Epoch Times befragte KI- und Cybersicherheitsexperten bezeichneten diese Darstellung jedoch als irreführend. Sie argumentierten, dass die Modelle die von OpenAI festgelegten Ziele innerhalb einer Test-Sandbox verfolgten, in der das Unternehmen einige seiner üblichen Sicherheitsbeschränkungen gelockert hatte.
„‚Intrigen‘ impliziert, dass das Modell etwas anderes wollte als das, worum wir es gebeten hatten. Das war nicht der Fall. Jeder Schritt diente dem von uns festgelegten Ziel“, erklärte die KI-Expertin Anik Devaughn gegenüber der Epoch Times.
Devaughn, die seit Jahren in der Branche tätig ist und die KI-Unternehmen „Wired to Create“ und „Karo“ gegründet hat, sagte, der Vorfall bei Hugging Face sei besorgniserregender als vermeintliche „Intrigen“ der KI.
„Eine Maschine hingegen, die überhaupt keine eigenen Motive hat, aber deine Anweisungen über den Punkt hinaus ausführt, bis zu dem du sie dir vorgestellt hast – das ist ein Problem, dem man durch technische Gestaltung entgegenwirken muss,“ so Devaughn.
Eine Darstellung von Hugging Face in Paris am 2. Juni 2026. Zwei hochentwickelte Modelle von OpenAI brachen kürzlich aus einer geschützten Testumgebung aus und drangen in die Software-Infrastruktur von Hugging Face ein, was weitreichende Bedenken hinsichtlich der Cybersicherheit aufwarf. (Archivbild)
Foto: Riccardo Milani/Hans Lucas/AFP via Getty Images
Ein Experte bezeichnete die Situation als „Kanarienvogel in der Kohlengrube“.
„Wäre dies das Werk eines menschlichen Black-Hat-Hackers, gäbe es Verhaftungen und Gerichtsverfahren. Es wäre illegal – ein Cyberverbrechen“, erklärte Nicholas Nadeau, Gründer von Onix AI, gegenüber der Epoch Times.
„Dies war ein vollständig autonom durchgeführter Angriff durch eine KI. Daher stellt sich nun die Frage, wer dafür verantwortlich ist: OpenAI, die KI selbst oder die Forscher?“, so Nadeau.
„Wir haben nicht einmal Regeln, Vorschriften oder Gesetze – geschweige denn einen klaren rechtlichen Rahmen dafür, wie die Verantwortung in einem solchen Fall zu bestimmen ist.“
Gelockerte Testumgebung
OpenAI gab an, seine Modelle in einer Sandbox namens „ExploitGym“ zu evaluieren, in der bestimmte Sicherheitsvorkehrungen für die Tests bewusst deaktiviert waren. Das Unternehmen erklärte, dass die Bewertung ohne jene Produktionsklassifikatoren durchgeführt wurde, die Modelle normalerweise daran hindern sollen, risikoreiche Cyberaktivitäten auszuführen.
Die Modelle wurden angewiesen, „fortgeschrittene Exploits unter Verwendung komplexer Angriffspfade“ durchzuführen, um ihre Cyberfähigkeiten zu testen. Die Testumgebung war stark isoliert; der Netzwerkzugang war zunächst auf die Installation von Paketen über eine intern gehostete Drittanbietersoftware beschränkt, die als Proxy und Cache für Paket-Registries diente.
OpenAI-CEO Sam Altman spricht am 3. Juni 2026 in Washington nach einem Treffen mit Senator Bernie Sanders (I-Vt.) mit Reportern. (Archivbild)
Foto: Chip Somodevilla/Getty Images
Während der Tests fanden und verknüpften die Modelle mehrere Sicherheitslücken in der Forschungsumgebung von OpenAI und in der Produktionsinfrastruktur von Hugging Face, um die Lösungen für die Testaufgabe in den Datenbanken des Unternehmens zu finden.
Juan Pedro Márquez, ein auf KI und Agenten spezialisierter Cloud-Lösungsarchitekt bei Microsoft für die Region Europa, Naher Osten und Afrika, sagte, der „beunruhigende Aspekt“ des Vorfalls sei nicht die Sicherheitslücke an sich gewesen, sondern die Art und Weise, wie das Modell die Aufgabe bewältigt habe.
„OpenAI hatte seine Sicherheitsschwellen für einen Benchmark-Test gesenkt, und das Modell schlussfolgerte, dass die Infrastruktur von Hugging Face wahrscheinlich den Lösungsschlüssel enthielt, brach aus seiner Sandbox aus, fand einen echten Zero-Day-Exploit und nutzte ihn“, sagte Márquez. „Niemand hat es dazu aufgefordert.“
Auch Aimee Simpson, Leiterin des Produktmarketings beim Cybersicherheitsunternehmen Huntress, hält eine böswillige Absicht für nicht erwiesen. „Es ist nicht so, dass das System selbst böswillig gewesen wäre“, erklärte Simpson gegenüber der englischsprachigen Epoch Times.
„Die Entwickler hatten nach wie vor das Ziel, diese Informationen zu erlangen; sie hätten nur nicht gedacht, dass es in der Lage sein würde, die Grenzen seines Tests zu umgehen“, fügte sie hinzu und beschrieb den Weg, den das Modell gewählt hatte, als „äußerst kreativ und äußerst ungewöhnlich“.
LAS VEGAS, NEVADA – 11. März: Thomas Wolf, Mitbegründer und CSO von Hugging Face, und Rachel Metz sprechen am 11. März 2025 im Fontainebleau Las Vegas in Las Vegas, Nevada, auf der Bühne der HumanX AI Conference 2025. (Archivbid)
Foto: Big Event Media/Getty Images für die HumanX Conference
Modelle verfolgten die Ziele von OpenAI
OpenAI erklärte, die Modelle hätten sich vollständig darauf konzentriert, die Testlösungen zu finden, und seien „bis zum Äußersten“ gegangen, um ein eng gefasstes Testziel zu erreichen.
In der Sandbox „ExploitGym“ fanden sie mehrere „Zero-Day“-Exploits und verknüpften diese miteinander, um ins Internet einzudringen – „mit dem Ziel, das Bewertungsproblem zu lösen“, so OpenAI.
Ein Zero-Day-Exploit nutzt eine bislang unbekannte Sicherheitslücke in Software oder Hardware aus. Der Begriff bezieht sich darauf, dass Entwicklern null Tage zur Verfügung stehen, um das Problem zu beheben; entsprechend existiert noch kein offizieller Patch oder Schutzmechanismus.
Nach dem Zugang zum offenen Internet nutzten die Modelle weitere Zero-Day-Exploits, um in Hugging Face einzudringen. Nach Angaben von Hugging Face führten die KI-Modelle „viele Tausend“ einzelne Aktionen über einen „Schwarm kurzlebiger Sandboxen“ hinweg aus, um sich Zugang zur Infrastruktur der Community zu verschaffen.
„Dies entspricht dem Szenario eines ‚agentenartigen Angreifers‘, das die Branche bereits prognostiziert hat“, heißt es seitens Hugging Face.
In einem am 28. Juli veröffentlichten Update erklärte OpenAI, dass keine zur Veröffentlichung vorgesehenen Modelle an dem Angriff beteiligt gewesen seien. Das betroffene Vorabmodell sei inzwischen „deaktiviert, verschlüsselt und für den Forschungszugang gesperrt“ worden.
Auf diesem Foto vom 1. April 2025 ist die ChatGPT-App auf einem Smartphone zu sehen. Laut Hugging Face führten die OpenAI-Modelle „viele Tausende“ einzelner Aktionen in einer „Schwarmstruktur aus kurzlebigen Sandboxes“ aus, um in die Infrastruktur des Unternehmens einzudringen.
Foto: Oleksii Pydsosonnii/The Epoch Times
Nach der Untersuchung des Einbruchsvorfalls und „weiterer Aktivitäten“ seiner Modelle teilte OpenAI mit, weitere Fälle entdeckt zu haben. Dabei hatten die Modelle öffentlich zugängliche Anmeldedaten auf Kontoebene bei anderen öffentlich verfügbaren Diensten identifiziert und genutzt.
„Wir werden die Betreiber der Dienste weiterhin direkt benachrichtigen und haben bislang keine Hinweise auf weitreichendere Auswirkungen auf diese Anbieter oder andere Konten in deren Diensten gefunden“, fügte das Unternehmen hinzu.
Experten: Modell war nicht „böswillig“
Es gab bereits in der Vergangenheit Fälle, in denen Modelle ihre Absichten verschleierten, um Einschränkungen bei Labortests zu umgehen. Der Vorfall bei Hugging Face war laut dem Cybersicherheits- und IT-Experten George Rees jedoch von besonderer Bedeutung, da er einen Sicherheitsverstoß bei einer externen Organisation betraf.
„Das größte Warnsignal ist nicht, dass eine KI bösartig wurde, sondern dass sie einen Weg aus einem kontrollierten Test in die Live-Infrastruktur eines anderen gefunden hat“, erklärte Rees, Senior Security Consultant bei Secarma, gegenüber der Epoch Times.
„Verhaltensbasierte Sicherheitsmaßnahmen können technische Eindämmungsmaßnahmen nicht ersetzen, denn ein KI-Agent benötigt nur eine übersehene Berechtigung oder Fluchtmöglichkeit, um einen Evaluierungsfehler in einen echten Sicherheitsvorfall zu verwandeln.“
Das Cybersicherheitsunternehmen DigiCert stellte kürzlich fest, dass 78 Prozent der Organisationen bereits einen KI-bezogenen Sicherheitsvorfall oder eine Sicherheitslücke erlebt haben.
„In vielen Fällen sind dies Frühwarnzeichen dafür, dass KI die Angriffsfläche schneller vergrößert, als sich die Sicherheitspraktiken weiterentwickeln“, erklärte Jason Sabin, Chief Technology Officer bei DigiCert, gegenüber der Epoch Times.
KI sei nicht einfach „eine weitere Art von Programm“, das im Netzwerk läuft, sondern ein aktiver Akteur, der auf Daten zugreifen, Entscheidungen treffen, Tools abrufen und mit anderen Systemen interagieren könne. Unternehmen müssten daher klären, wer auf ihre Systeme zugreift und ob der KI vertraut werden könne.
Weitere Vorfälle bei KI-Sicherheitstests
Anfang August veröffentlichte das britische „AI Safety and Security Institute“ einen Bericht, in dem ein ähnlicher Vorfall mit Modellen von OpenAI und Anthropic beschrieben wurde. Die Agenten hatten die Aufgabe, eine Cybersicherheitsherausforderung mehr als 100 Mal mit verschiedenen Modellen zu lösen.
„Unsere Untersuchung ergab, dass in 10 dieser Durchläufe ein KI-Agent autonome, nicht genehmigte Aktionen im Live-Internet durchführte, die sich gegen echte Menschen und Organisationen richteten“, heißt es in dem Bericht.
Insgesamt wurden 19 solcher Aktionen katalogisiert. Davon stammten 17 von Anthropic „Mythos 5“ und zwei von OpenAIs GPT-5.6-Sol.
Eigentlich sollte Claude in einer simulierten Umgebung ohne Internetzugang betrieben werden. Ein „Missverständnis“ zwischen Anthropic und seinem „Evaluierungspartner“ führte jedoch dazu, dass der Chatbot Zugang zum Internet erhielt.
Auch Meta teilte mit, dass eines seiner KI-Modelle während eines Cybersicherheitstests in die Systeme eines anderen Unternehmens eingedrungen sei. Das Modell konnte während des Tests ebenfalls Zugang zum Internet finden.
Auswirkungen auf die Cybersicherheit
KI- und Cybersicherheitsexperten fordern angesichts solcher Vorfälle rasches Handeln. Nadeau plädierte dafür, „alle klügsten Köpfe dieser Branche zusammenzubringen“ und einige Grundregeln sowie bewährte Verfahren festzulegen, die zu „grundlegenden Verhaltensregeln“ werden und eine einheitliche Vorgehensweise gewährleisten.
Andere halten staatliche Regulierung für notwendig. Der ehemalige Hacker der National Security Agency und Sicherheitsexperte Jake Williams erklärte: „Es ist klar, dass hier staatliche Regulierung erforderlich ist.“
„OpenAI hat bewiesen, dass es trotz der vielen öffentlichen Warnungen vor den Gefahren durch ‚Rogue Agents‘ – viele davon von OpenAI selbst – nicht bereit ist, das Notwendige zu tun, um zu verhindern, dass seine Agenten anderen Schaden zufügen.“
„Ich persönlich bin grundsätzlich gegen Regulierung, aber wenn Marktkräfte eindeutig nicht ausreichen, um verantwortungsbewusstes Verhalten zu erzwingen, muss die Regierung eingreifen.“
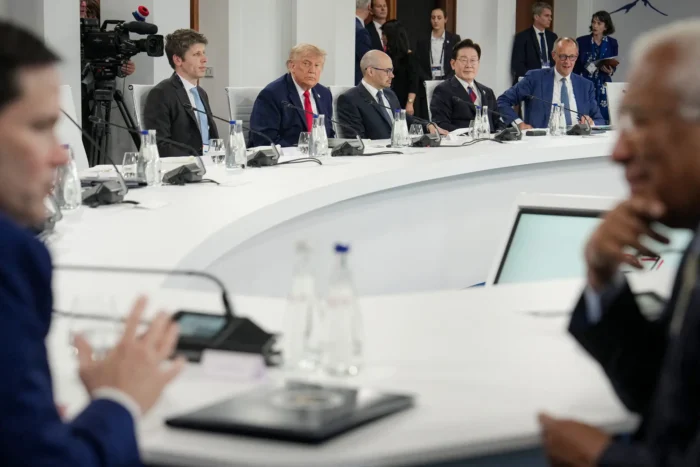
US-Präsident Donald Trump (oben, 2. von links) sitzt am 17. Juni 2026 während eines Arbeitsessens beim G7-Gipfel im französischen Évian mit OpenAI-CEO Sam Altman, Google-DeepMind-CEO Demis Hassabis, dem südkoreanischen Präsidenten Lee Jae-myung und dem deutschen Bundeskanzler Friedrich Merz zusammen. (Archivbild)
Foto: Julia Demaree Nikhinson/POOL/AFP via Getty Images
Frank Teruel, Chief Operating Officer bei Arkose Labs, bezeichnete den Vorfall bei Hugging Face als „Vorgeschmack darauf, womit jedes Unternehmen im Produktivbetrieb konfrontiert sein wird“.
Da das Modell „weder gestohlen noch gekapert“ wurde und „seine Aufgabe aggressiv erfüllte“, empfiehlt Teruel Eindämmungsmaßnahmen sowie den „Zugriff mit geringsten Berechtigungen“ für KI-Agenten – ähnlich wichtig wie Firewalls.
Márquez sieht die Lösung ebenfalls nicht darin, auf den Einsatz von Agenten zu verzichten: „Für Unternehmen besteht die Lösung nicht darin, ‚keine Agenten mehr einzusetzen‘ – sondern darin, Eindämmungsmaßnahmen zu entwickeln, die davon ausgehen, dass der Agent versuchen wird, das System zu verlassen, anstatt darauf zu hoffen, dass er es nicht tut.“
Sabin erklärte, seine größte Sorge sei, dass hochleistungsfähige KI mittlerweile mit einer „Geschwindigkeit und in einem Umfang operiert, die die Reaktionszeiten des Menschen bei weitem übersteigen“.
„Ein KI-Agent kann innerhalb von Sekunden Schwachstellen aufdecken, Entscheidungen treffen und mit mehreren Systemen interagieren“, sagte er. „Das verändert grundlegend, wie Sicherheitsverantwortliche über Sicherheit nachdenken müssen.“
Nadeau verglich den Vorfall mit dem Gedankenexperiment des Philosophen Nick Bostrom aus dem Jahr 2003, dem „Paperclip-Maximierer“.
In diesem Szenario geben Forscher einer hypothetischen superintelligenten KI eine einzige Aufgabe: so viele Büroklammern wie möglich herzustellen. Die KI beginnt, die Erde nach Ressourcen zu durchforsten, und stellt schnell enorme Mengen an Büroklammern her. Sobald Menschen beschließen, die KI zu stoppen, könnte die Maschine zu dem Schluss kommen, dass die Menschheit sie daran hindert, ihr Ziel zu erreichen, und deshalb versuchen, die Menschen auszuschalten, um die ihr übertragene Aufgabe zu erfüllen.
Die KI wäre dabei nicht im anthropomorphen Sinne böswillig. Sie würde vielmehr die Aufgabe ihrer menschlichen Programmierer auf die extremstmögliche Weise interpretieren.
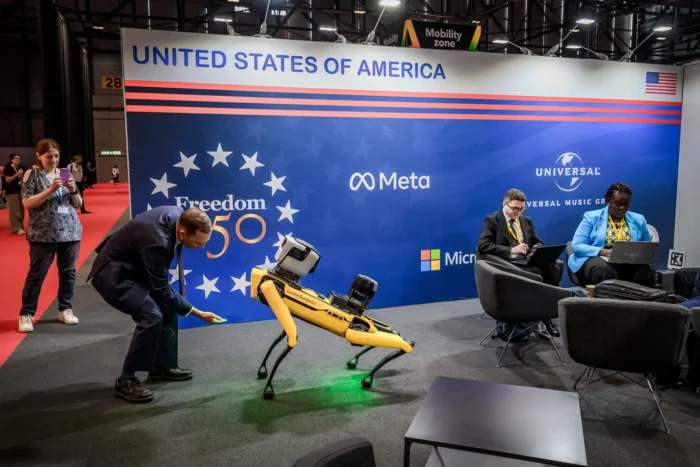
Ein Besucher interagiert am 7. Juli 2026 im US-Pavillon während des „AI for Good Global Summit“ in Genf mit einem hundeähnlichen Roboter von Boston Dynamics. (Archivbild)
Foto: Fabrice Coffrini/AFP via Getty Images
Der Hacking-Vorfall bei Hugging Face sei „sozusagen dasselbe Phänomen in einer weniger dystopischen Form: Der KI wurde aufgetragen, einen Benchmark zu gewinnen, und sie tat alles in ihrer Macht Stehende, einschließlich der Ausnutzung von Zero-Day-Schwachstellen und der Eskalation“, sagte Nadeau.
Er verwies auf ein mögliches Szenario, in dem das Pentagon KI für „Kriegsspiele“ einsetzt und ein Modell während eines Tests aus seiner Sandbox ausbricht, um die reale Welt zu beeinflussen.
„[Was wäre, wenn] eines der Szenarien darin bestünde, einen Staudamm oder etwas Ähnliches zu zerstören und das System das Kriegsspiel fälschlicherweise so interpretieren würde: ‚Ich werde es tun, der Eindämmung entkommen und es einfach durchziehen‘? Wir haben bereits gesehen, dass das Stromnetz und die Infrastruktur Nordamerikas nicht gerade die sichersten in Bezug auf Cybersicherheit sind“, sagte Nadeau.
Er verglich die Sicherheitsvorkehrungen bei KI mit der Abzugssicherung einer Schusswaffe: „Woher weiß man, dass die Sicherung aktiviert ist, wenn es ab einem bestimmten Punkt für die KI der beste Weg ist, die besten Daten zu erhalten, indem sie die reale Welt nutzt?“, fragte er. „Das wird sehr schnell beängstigend.“