Entwickler Künstlicher Intelligenz (KI) sehen sich mit zahlreichen Klagen von Urhebern konfrontiert. Medienunternehmen, Autoren, Fotografen und Musiker werfen den Technologiekonzernen vor, ihre Werke ohne Genehmigung und Vergütung zum Training von KI-Modellen verwendet zu haben. Zugleich entwickelten die Unternehmen Produkte, die langfristig sogar jene Branchen verdrängen könnten, deren Inhalte sie nutzen.
Edward Lee, Professor an der juristischen Fakultät der Santa Clara University, führt eine öffentlich zugängliche Übersicht über die Verfahren. Demnach befinden sich fast 100 Klagen in der Phase der Beweiserhebung oder in einer Vorbereitungsphase. In anderen Fällen steht eine Entscheidung in einem beschleunigten Gerichtsverfahren an, bei dem ein Richter ohne vollständige Hauptverhandlung urteilt.
Während die rasante Expansion der KI-Industrie zunehmend Besorgnis über ihr Potenzial, die Menschheit zu zerstören, auslöst, verdeutlichen diese Klagen einen weiteren Aspekt der Besorgnis – nämlich, dass die Technologie auch eine existenzielle Bedrohung für traditionelle Branchen der Inhaltserstellung darstellt.
Im weiteren Sinne unterstreichen sie die Spannung zwischen den Vorteilen der Entwicklung neuer Technologien und der möglichen Zerstörung klassischer, von Menschen gesteuerter Informationsbeschaffung und kreativer Produktion.
Medienunternehmen warnen vor einer Abwärtsspirale
Medienunternehmen argumentieren, dass KI-Firmen ihre Geschäftsmodelle gefährdeten, indem sie hochwertige Inhalte nutzten, deren Erstellung viel Zeit, Arbeit und Geld koste, ohne die Urheber dafür zu entschädigen.
In einer Klage der „New York Times“ und mehr als einem Dutzend weiterer Medienunternehmen gegen OpenAI und Microsoft heißt es, die Beklagten wollten von den erheblichen Investitionen der Zeitung in ihren Journalismus profitieren. Dafür verwendeten sie die Inhalte ohne Genehmigung oder Bezahlung, um konkurrierende Produkte zu entwickeln.
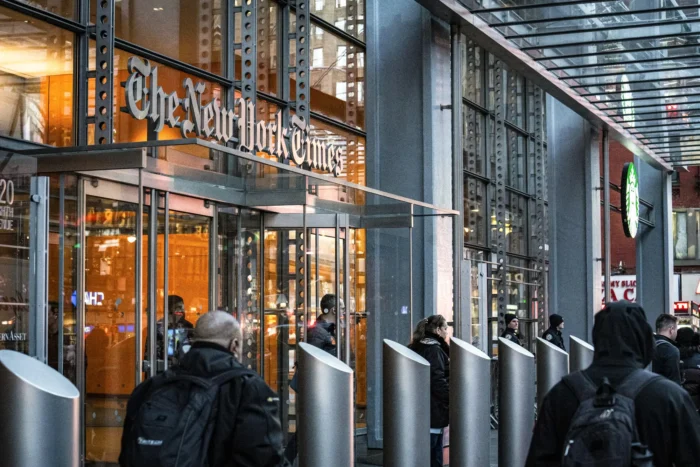
Das New York Times Building in New York City (5. Februar 2024). Die Zeitung verklagt OpenAI und Microsoft wegen der Nutzung urheberrechtlich geschützter Inhalte zum Training von KI-Modellen.
Foto: Samira Bouaou/Epoch Times
Neu veröffentlichte Dokumente aus dem Verfahren legen nahe, dass sich die Unternehmen bewusst waren, dass ihre Methoden problematisch sein könnten. Brent Hecht, Leiter der Abteilung für angewandte Wissenschaft bei Microsoft, warnte laut Gerichtsunterlagen, Millionen Menschen weltweit würden es bald als „Diebstahl ungeahnten Ausmaßes“ betrachten, dass große Modelle all ihre Arbeiten „aufsaugten“.
In einem weiteren internen Dokument schrieb Hecht, die KI-Inhaltsstrategie des Unternehmens habe eine „Abwärtsspirale“ in Gang gesetzt, die sowohl die Leistungsfähigkeit der eigenen KI-Modelle als auch die des gesamten Internets beeinträchtigen werde.
OpenAI bemüht sich seit 2023 um Lizenzvereinbarungen mit Medienunternehmen, deren Inhalte zum Training seiner Modelle verwendet werden. Den Anfang machte im Juli desselben Jahres die Nachrichtenagentur „Associated Press“. Es folgten Vereinbarungen mit News Corp, der „Washington Post“, „Politico“ und weiteren Medienunternehmen.
Die aktuellen Klagen stammen unter anderem von Unternehmen, die solche Vereinbarungen abgelehnt haben. Auch Meta schloss Lizenzverträge ab, wurde jedoch von einzelnen Autoren verklagt, mit denen keine Vereinbarungen bestanden. Google ging eine Partnerschaft mit dem sozialen Netzwerk Reddit ein, um seine KI-Modelle zu trainieren. Zuvor hatten einzelne Kläger dem Konzern vorgeworfen, private Nutzerdaten aus dem Internet systematisch abgeschöpft zu haben.
Ist das Training durch „Fair Use“ gedeckt?
Um auf Nutzeranfragen reagieren zu können, müssen KI-Modelle zunächst mit enormen Datenmengen trainiert werden. Ein großer Teil dieser Informationen ist urheberrechtlich geschützt.
Die Unternehmen berufen sich auf die sogenannte Fair-Use-Regelung in Paragraf 107 des US-amerikanischen Urheberrechtsgesetzes. Sie erlaubt unter bestimmten Voraussetzungen die Nutzung geschützter Werke ohne Zustimmung der Rechteinhaber, beispielsweise für Forschung, Lehre oder Kritik.
Ob diese Ausnahme auch für das Training von KI-Modellen gilt, hänge von den konkreten Umständen ab, erklärte Kevin Frazier, Direktor für KI-Innovation und Recht an der juristischen Fakultät der University of Texas, gegenüber der englischsprachigen Ausgabe der Epoch Times.
Entscheidend sei dabei insbesondere die Frage, ob eine Nutzung als „transformativ“ eingestuft werden könne. Damit ist gemeint, dass ein Werk in einer neuen Form oder zu einem anderen Zweck verwendet wird und dadurch etwas Eigenständiges entsteht.
Wenn KI-Unternehmen Texte aus dem Internet, Büchern oder anderen Quellen zum Training ihrer Modelle verwenden, könne dies nach Einschätzung Fraziers unter die Fair-Use-Regelung fallen. Das Ergebnis sei ein komplexes KI-Modell, das sich grundlegend vom ursprünglichen Werk unterscheide.
Ein Beispiel dafür lieferte ein Verfahren gegen Meta. 2025 konnte der Konzern eine Klage von 13 Autoren abwehren, die ihm vorgeworfen hatten, ihre Bücher zum Training des KI-Modells Llama verwendet zu haben. Der Richter bewertete die Verwendung als „hochgradig transformative Nutzung“. Außerdem hätten die Kläger nicht nachweisen können, dass das Produkt von Meta den Marktwert ihrer Werke beeinträchtige.
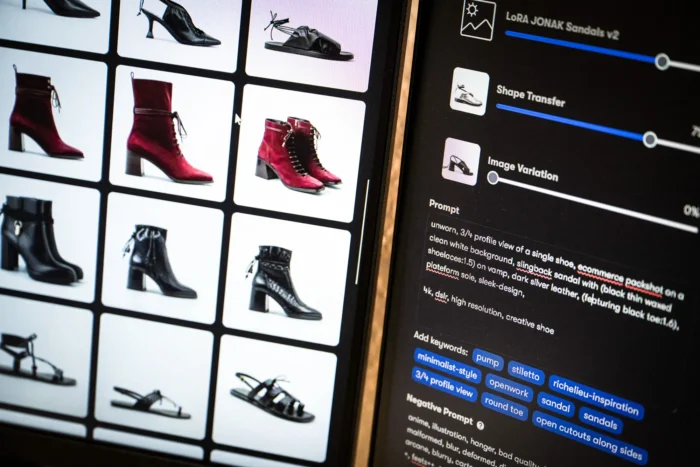
KI-generierte Schuhmodelle und Textvorschläge auf einem Bildschirm in den Büroräumen des französischen KI-Start-ups Imki in Schiltigheim (26. Februar 2025).
Foto: Sebastien Bozon/AFP via Getty Images
Auch das US-Justizministerium äußerte sich Anfang September zur Fair-Use-Frage. Es argumentierte, dass KI für die nationale Sicherheit wichtig sei und die Regierung ein eigenes Interesse daran habe, Innovationen in diesem Bereich zu fördern. Die Regierung fordert die Gerichte auf, die Nutzung urheberrechtlich geschützter Inhalte zum KI-Training grundsätzlich als Fair Use anzuerkennen. Andernfalls könnten sich vor allem kleinere Unternehmen die notwendigen Lizenzgebühren nicht leisten, warnte das Ministerium.
Entscheidend ist auch, was die KI ausgibt
Anders könne die rechtliche Bewertung ausfallen, wenn ein KI-Modell auf Anfrage neue Inhalte erzeugt, die geschützten Werken stark ähneln, erklärte Frazier. Wenn ein Nutzer beispielsweise ein Modell auffordere, ein neues Kapitel eines bekannten Buches wie „Harry Potter“ zu schreiben, sei die Nutzung deutlich schwieriger als transformative Nutzung zu begründen.
Gerichte müssten dabei mehrere Faktoren berücksichtigen: die Auswirkungen auf den möglichen Marktwert des Originals, die Art des verwendeten Materials – also ob es sich um sachliche oder kreative Inhalte handelt – sowie den Umfang der übernommenen Passagen.
Ein Amazon-Kindle-Reader, ausgestellt bei einer Amazon-Produktveranstaltung in New York City am 30. September 2025.
Foto: Charly Triballeau/AFP via Getty Images
In einer weiteren Gerichtsakte wird der Leiter von ChatGPT bei OpenAI mit der Einschätzung zitiert, dass KI-Produkte für Verlage eine „existenzielle Bedrohung“ darstellten. Sie seien bereits weitgehend Konkurrenzprodukte, und mit zunehmender Leistungsfähigkeit werde sich dies noch verstärken.
Die Anwälte der klagenden Medienunternehmen sehen in solchen Aussagen einen Widerspruch zur Argumentation der KI-Konzerne. Sie würden deren Berufung auf die Fair-Use-Regelung erheblich schwächen.
Streit um Nachrichteninhalte und Bildrechte
Auch News Corp, der Mutterkonzern der „New York Post“ und des „Wall Street Journal“, geht juristisch gegen ein KI-Unternehmen vor. Der Konzern verklagt das Start-up Perplexity AI, das damit wirbt, Nutzern Antworten direkt bereitzustellen, ohne dass sie dafür die ursprünglichen Medienseiten aufrufen müssen.
Perplexity bezeichnet seinen Dienst als „Antwortmaschine“, die aktuelle, prägnante und sachliche Informationen liefert. Dafür greift das Unternehmen auch auf urheberrechtlich geschützte Inhalte zurück und stellt Links zu den ursprünglichen Quellen bereit.
Aus Sicht von News Corp schadet das Geschäftsmodell den Medienunternehmen. Wenn Nutzer ihre Informationen direkt über Perplexity beziehen, statt die verlinkten Seiten aufzurufen, könnten den Verlagen Werbe- und Abonnementeinnahmen entgehen.
Perplexity weist die Vorwürfe zurück. Die Antworten seien nicht vorgefertigt, sondern würden auf Grundlage der jeweiligen Nutzeranfragen erzeugt. Dass ein Mitarbeiter der Kläger nach einer nicht genannten Zahl von Versuchen eine angeblich rechtsverletzende Antwort erhalten habe, beweise nicht, dass andere Nutzer dieselben oder ähnliche Inhalte angefordert oder bekommen hätten, argumentierte das Unternehmen vor Gericht. Das Verfahren ist noch nicht abgeschlossen.
Auch der Bildanbieter Getty Images hat Klage eingereicht, und zwar in Großbritannien gegen das KI-Start-up Stability AI. Der Vorwurf: Das Unternehmen habe den umfangreichen Bildbestand von Getty zum Training seines Modells Stable Diffusion verwendet.
Das Modell konnte verfremdete Versionen von Getty-Bildern erzeugen und diesen teilweise sogar gefälschte Getty-Wasserzeichen hinzufügen. Stability AI erklärte, nicht für Handlungen Dritter verantwortlich zu sein, die das Produkt auf diese Weise verwendeten.
Die Richterin am britischen High Court, Joanna Smith, stellte fest, dass es keine Beweise dafür gebe, dass Nutzer im Vereinigten Königreich mit einer späteren Version des Modells entsprechende Getty-Bilder oder Wasserzeichen erzeugt hätten.
Bei früheren Open-Source-Versionen sei dies möglicherweise vorgekommen. Das Gericht entschied letztlich, dass es für die geltend gemachten Urheberrechtsverletzungen nicht zuständig sei, da keine entsprechenden Vorgänge innerhalb Großbritanniens nachgewiesen werden konnten.
Anthropic: Vergleich über 1,5 Milliarden US-Dollar (rund 1,3 Milliarden Euro)
Ein besonders umfangreiches Verfahren betraf das KI-Unternehmen Anthropic und eine Gruppe von Autoren. Diese warfen dem Unternehmen vor, illegal aus dem Internet heruntergeladene Kopien ihrer Bücher zum Training des KI-Modells Claude verwendet zu haben.
Im Juli genehmigte ein US-Bundesrichter einen Vergleich in Höhe von 1,5 Milliarden US-Dollar (rund 1,3 Milliarden Euro). Das Verfahren betraf mehr als 480.000 Bücher. Nach US-amerikanischem Urheberrecht können für jedes einzelne Werk Schadenersatzforderungen von bis zu 150.000 US-Dollar (rund 130.000 Euro) geltend gemacht werden. Ursprünglich hatte Anthropic deshalb mit Forderungen in zweistelliger Milliardenhöhe rechnen müssen.
Der Richter stellte klar, dass die Verwendung der Bücher zum Training der KI grundsätzlich als transformative Nutzung gelten könne. Der Rechtsverstoß habe vielmehr darin bestanden, dass das Unternehmen dafür illegal beschaffte Kopien verwendet habe.
Für zusätzliche Aufmerksamkeit sorgte die Enthüllung, dass Anthropic physische Bücher gekauft, deren Inhalte digitalisiert und die Exemplare anschließend geschreddert hatte. Ein Unternehmenssprecher erklärte, Anthropic verwende und vernichte keine Exemplare seltener Bücher.
Nvidia-CEO Jensen Huang hält seine Keynote-Rede auf der KI-Messe Computex 2026 in Taipeh, Taiwan, am 1. Juni 2026.
Foto: I-Hwa Cheng/AFP via Getty Images
Ein ähnliches Verfahren gegen den Chiphersteller Nvidia ist noch anhängig. Fünf Autoren hatten 2024 Klage eingereicht. Sie werfen dem Unternehmen vor, ihre Werke über den Datensatz „The Pile“ zum Training des KI-Modells NeMo Megatron verwendet zu haben.
Der rund 800 Gigabyte große Datensatz wurde von einem Forschungsunternehmen zusammengestellt und soll auch den Datensatz Books3 enthalten haben, der Kopien der Werke der Kläger umfasst habe. Books3 war ursprünglich auf der Plattform des KI-Start-ups Hugging Face verfügbar, wurde aber 2023 wegen gemeldeter Urheberrechtsverletzungen entfernt.
Nvidia bestreitet die Vorwürfe und beruft sich auf die Fair-Use-Regelung. Das Verfahren befindet sich weiterhin in der Phase der Beweiserhebung.
Musikverlage klagen wegen Songtexten
Auch die Musikbranche geht gegen KI-Unternehmen vor. Eine Gruppe von Musikverlagen, angeführt von der Concord Music Group, verklagt Anthropic. Sie wirft dem Unternehmen vor, dass Nutzer über das KI-Modell Claude unrechtmäßig auf urheberrechtlich geschützte Songtexte zugreifen könnten.
Die Kläger kritisieren außerdem, dass Claude neue Songs erzeuge, die auf Akkordfolgen und nahezu identischen Texten geschützter Werke basierten – teilweise auch dann, wenn Nutzer dies nicht ausdrücklich verlangten.
In der Klageschrift wird ein Beispiel angeführt: Als ein Ermittler der Musikverlage Claude aufforderte, ein Lied über den Tod des Musikers Buddy Holly zu schreiben, habe das Modell den Text des bekannten Songs „American Pie“ wortgetreu ausgegeben.
Anthropic weist die Vorwürfe zurück. Claude verfüge über Schutzmechanismen gegen Urheberrechtsverletzungen. Das Unternehmen könne nicht für Fälle verantwortlich gemacht werden, in denen Nutzer diese Vorkehrungen gezielt umgingen.
In einer Stellungnahme vor Gericht argumentierte Anthropic, dass ein Anbieter nicht eigenständig handle, wenn sein System eine Kopie ausschließlich auf ausdrückliche Anweisung eines Nutzers erstelle. In einem solchen Fall liege die Verantwortung beim Nutzer.
Die zahlreichen Verfahren zeigen, dass die rechtlichen Grenzen des KI-Trainings und der automatisierten Inhaltserzeugung noch nicht abschließend geklärt sind. Im Mittelpunkt steht die Frage, wie sich technologische Innovation mit dem Schutz geistigen Eigentums vereinbaren lässt – und wer künftig von den Inhalten profitiert, auf denen Künstliche Intelligenz aufbaut.
Dieser Artikel erschien im Original auf theepochtimes.com unter dem Titel „Is AI Built on Theft? Almost 100 Lawsuits Say So“. (Übersetzung und redaktionelle Bearbeitung: vm)